概要
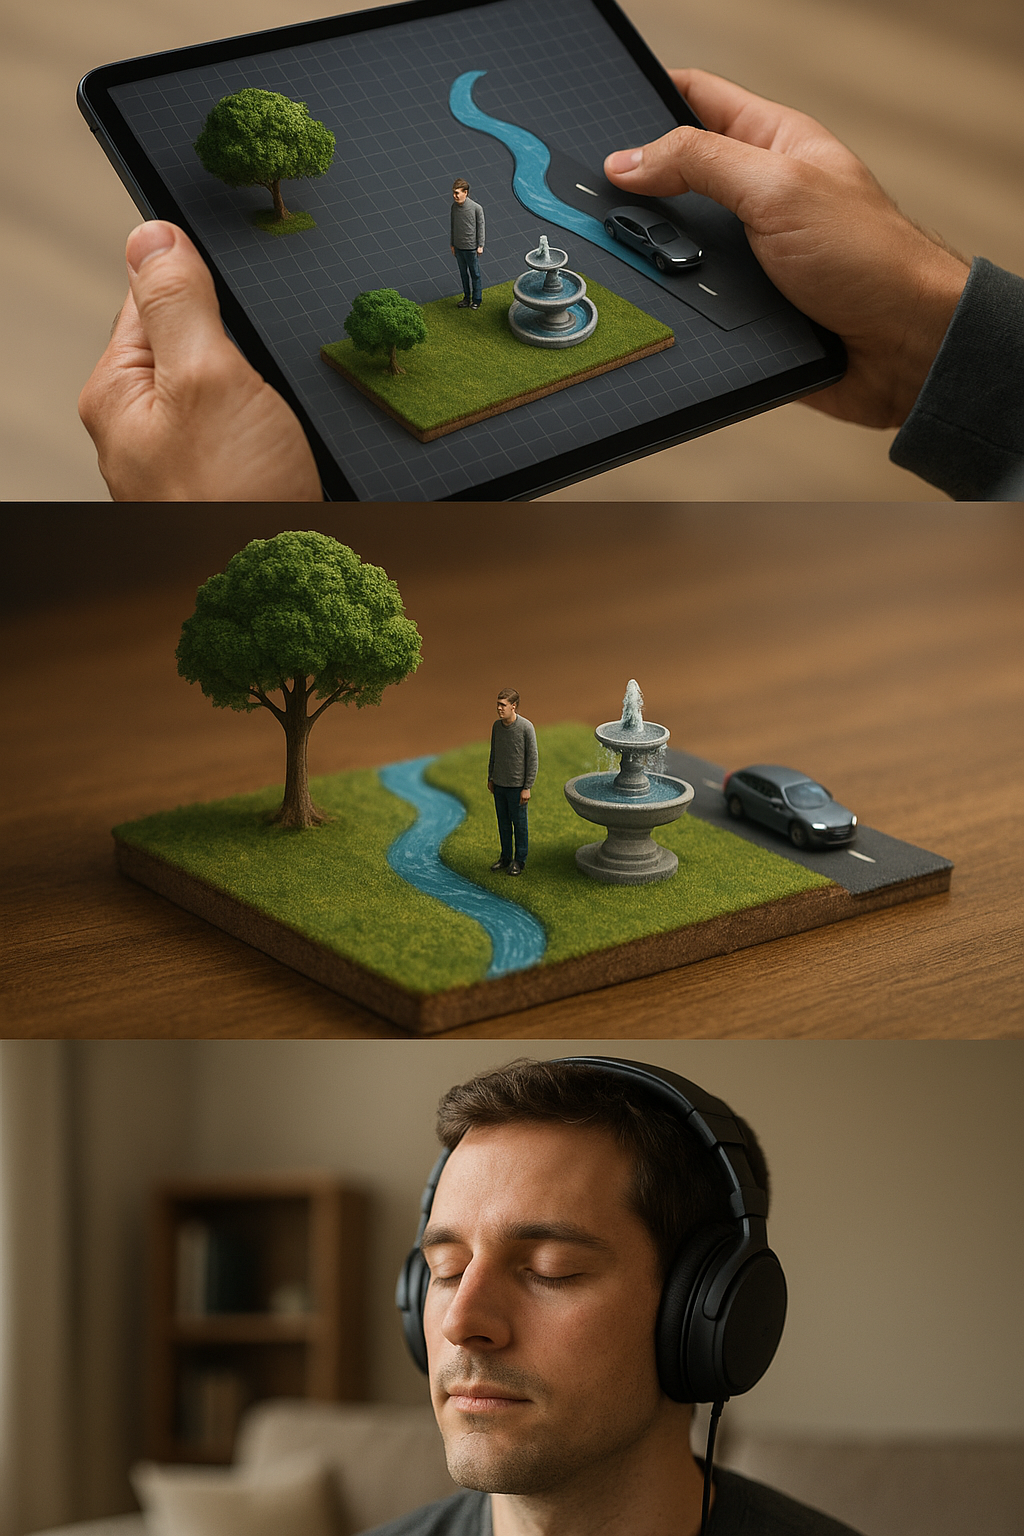
3年次のゼミので制作として、一枚の写真やカメラ画像から、その場にある物を読み取り、音を通して空間の印象をつくるiOSプロトタイプを制作した。「好きな環境音を自分で作る」という構想を出発点に、画像認識、環境音素材の生成、AirPodsでの立体音響を別々に試作し、視覚情報を聴覚的な体験へ変換する方法を探った。
背景
私は自宅で色々な場所の環境音をYouTubeで流して作業音として使うことがある。海外の街中の音や、海辺、観光地など自身の好みの場所の音を選んで流してるが、よりその日の気分に合わせた、好きな環境音を作って流したいと考えた。
さらに、オシャレなカフェの写真を見て、その場所の雰囲気で作業したいと考えたことがあり、写真から環境音を作成する制作に至った。
制作で考えたこと
画像認識、音生成、空間再生を一度に大きく作るのではなく、交換できる小さな実験として分けた。画像認識はMac上で動くOllamaのマルチモーダルモデル qwen3-vl:4b をFastAPI経由で呼び、カメラ画像から主要物体名と個数をJSONで受け取る。環境音素材の生成にはElevenLabs Sound Effects APIを用いた。実装済みの部分と、音の自動配置・統合再生という今後の構想を区別して扱っている。
実装・制作内容
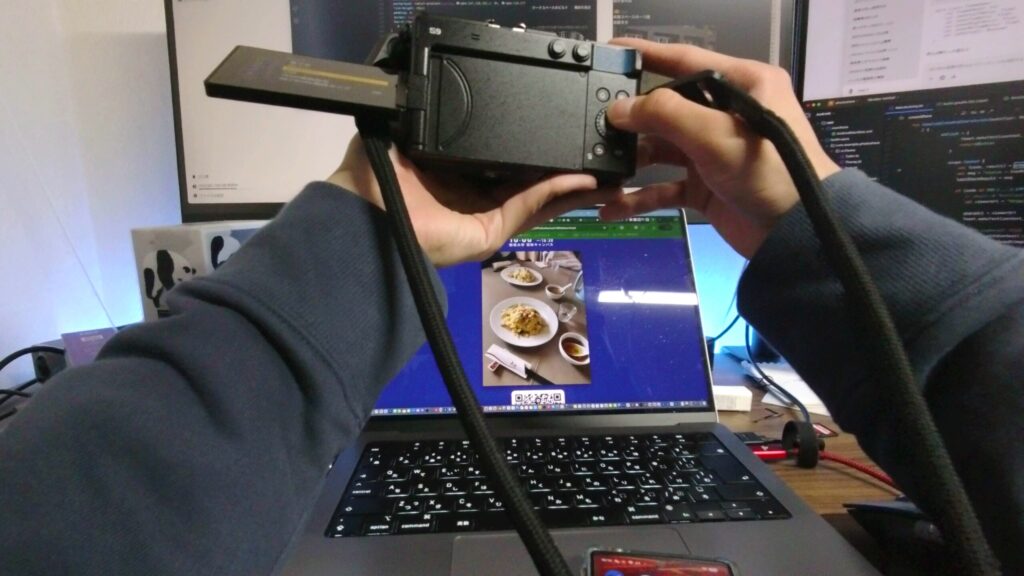
iOS側ではカメラ画像をJPEGとしてローカルAPIへ送る。空間再生にはAppleのPHASEEngineを使い、複数の環境音を半径3mの円周上に配置してループ再生する。CMHeadphoneMotionManager からAirPodsの頭部運動を取得し、聞き手の向きに合わせて音場を更新する。デバッグ画面では音場を手動で回転させ、複数音源の聞こえ方を検証できるようにした。
結果・学び
視覚情報を音へ変えるときは、写っている物をすべて音にするより、何を残し何を省くかが体験を左右することが分かった。物体認識の不安定さや情報量の多さも含め、感覚提示は技術の接続だけでは完成しない。この試作は、後の音源定位・振動定位の研究関心につながる出発点になっている。
